Les outils d’analyse de données se choisissent selon le volume, le métier et le niveau technique
Les outils d’analyse de données ne répondent pas tous au même besoin. Un tableur aide à explorer rapidement un fichier, SQL interroge des bases relationnelles, Python automatise des traitements complexes et Power BI rend les résultats lisibles dans un tableau de bord. Le choix dépend donc de la question métier, du volume à traiter et des compétences disponibles.
À quoi servent les outils d’analyse de données ?
L’analyse de données consiste à transformer des informations brutes en éléments utiles à la décision : tendances, anomalies, corrélations, segments clients ou indicateurs de performance. Les outils d’analyse de données couvrent l’ensemble de ce parcours, depuis la collecte jusqu’à la restitution. Ils peuvent prendre la forme d’un tableur, d’un langage de requête, d’un langage de programmation, d’une bibliothèque spécialisée ou d’une plateforme de visualisation.
Le rôle concret du data analyst
Un data analyst ne se limite pas à produire des graphiques. Il commence par clarifier la question à résoudre, récupère les bonnes sources, vérifie la fiabilité des valeurs, harmonise les formats, puis analyse et explique les résultats. Cette succession d’étapes évite de tirer des conclusions sur des données incomplètes, dupliquées ou mal interprétées. L’outil reste un moyen : le protocole d’analyse et la compréhension du métier guident les décisions.
Données quantitatives ou qualitatives : deux approches distinctes
Les données quantitatives regroupent des valeurs mesurables : chiffre d’affaires, nombre de commandes, délais, taux ou volumes. Elles se prêtent aux agrégations, à la régression linéaire, à l’analyse factorielle ou à l’étude de séries temporelles. Les données qualitatives proviennent plutôt de verbatims clients, d’entretiens, de réponses ouvertes, d’audios ou de vidéos. Elles demandent un travail de codage, de regroupement thématique, parfois de transcription ou d’analyse des sentiments. Un même projet peut combiner ces deux dimensions.
Associer chaque étape au bon outil
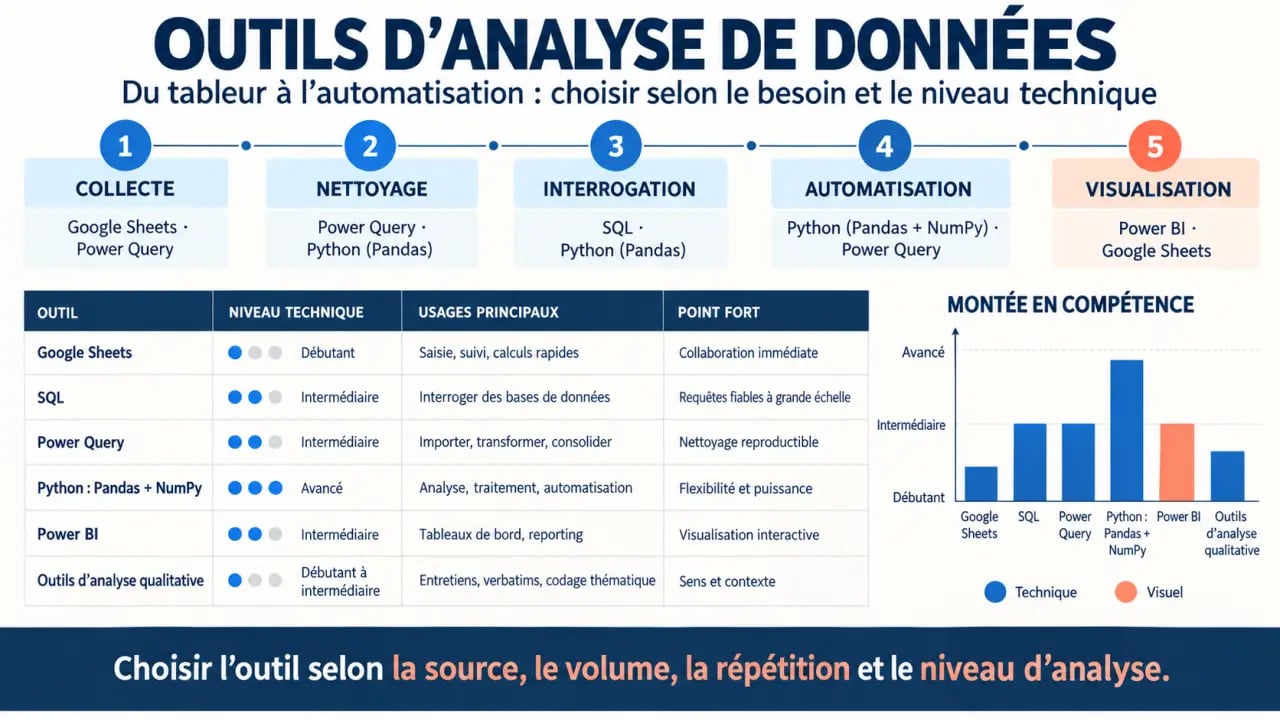
Une stack data efficace ne cherche pas à tout faire avec un seul logiciel. Elle répartit les tâches entre des outils complémentaires pour limiter les manipulations manuelles et préserver la traçabilité des traitements.
Collecter, interroger et réunir les sources
SQL est central lorsque les données sont stockées dans une base relationnelle. Il permet de filtrer, trier, agréger et joindre plusieurs tables pour extraire un jeu de données cohérent. Il est particulièrement pertinent pour rapprocher les commandes, les produits et les informations clients. Les données ouvertes peuvent aussi alimenter une analyse. On les trouve fréquemment en CSV, JSON, TXT ou MD, notamment sur des plateformes comme Kaggle, Data World, UNdata ou OpenDataSoft.
Nettoyer et transformer sans perdre le fil
Google Sheets convient à une première exploration : saisie, filtres, tris, formules, VLOOKUP et IF, avec une collaboration en temps réel. Dès que les règles de préparation doivent être répétées, Power Query devient plus adapté. Il extrait, transforme et charge les données, permet de modifier les types, de supprimer des colonnes, de fusionner des tables et de documenter une chaîne de transformations. Ses plus de 300 transformations répondent à de nombreux cas courants sans écrire de code, même si le langage M apporte davantage de souplesse aux utilisateurs avancés.
La préparation des données exige de conserver le même sens pour chaque colonne d’une source à l’autre. Une date écrite sous plusieurs formats, un identifiant avec ou sans zéro initial, ou une catégorie nommée différemment peuvent compromettre une jointure. Avant de calculer un indicateur, il est utile d’établir un dictionnaire de données, de normaliser les libellés et de conserver l’origine de chaque champ. L’analyse gagne ainsi en fiabilité et peut être reprise par une autre personne.
SQL, Python, Power BI : comparaison pour choisir sans se tromper
Ces solutions sont souvent opposées alors qu’elles interviennent à des moments différents. Le tableau suivant situe leur rôle, avec Google Sheets et les outils spécialisés dans l’analyse qualitative.
| Outil | Usage principal | Niveau technique | Point fort | Limite à anticiper |
|---|---|---|---|---|
| Google Sheets | Exploration, calculs simples, collaboration | Débutant | Prise en main immédiate | Moins adapté aux traitements complexes et répétitifs |
| SQL | Interrogation de bases relationnelles | Intermédiaire | Jointures et agrégations fiables | Nécessite l’accès et la compréhension du modèle de données |
| Power Query | Nettoyage et transformation | Débutant à intermédiaire | Automatisation visuelle des étapes | Moins flexible qu’un script pour des besoins très spécifiques |
| Python avec Pandas et NumPy | Manipulation, calcul, automatisation | Intermédiaire à avancé | Grande polyvalence et reproductibilité | Demande de maîtriser le code et son environnement |
| Power BI | Tableaux de bord et restitution | Intermédiaire | Visualisation et partage des indicateurs | Ne remplace pas une préparation de données rigoureuse |
| NVivo, Dovetail ou Thematic | Codage de contenus qualitatifs | Débutant à intermédiaire | Analyse structurée de verbatims et entretiens | Le codage exige une méthode d’interprétation claire |
Pourquoi Python reste une référence polyvalente
Python est un langage de programmation open source apprécié pour sa communauté et ses nombreuses bibliothèques. Pandas facilite l’alignement, la fusion, la manipulation et la transformation de jeux de données, y compris les séries temporelles. Il peut également être utilisé dans des flux incluant le web scraping. NumPy convient aux tableaux multidimensionnels et aux calculs mathématiques. Pour représenter les résultats, Matplotlib permet de créer des graphiques. Cette combinaison est adaptée lorsqu’il faut automatiser un traitement récurrent, consolider des fichiers hétérogènes ou construire une analyse reproductible.
Power BI pour faire comprendre plutôt que seulement calculer
Un tableau de bord ne doit pas être une accumulation de graphiques. Power BI sert à connecter des données préparées, à suivre des indicateurs et à proposer une lecture interactive aux parties prenantes. La visualisation soutient alors le data storytelling : elle met en évidence une évolution, une comparaison ou une anomalie, avec un niveau de détail adapté au décideur. Il faut définir les indicateurs, leurs règles de calcul et leur fréquence de mise à jour avant la conception visuelle.
Construire une combinaison d’outils adaptée à votre contexte
Pour un débutant, un parcours progressif est souvent plus efficace qu’une adoption immédiate de Python : commencer par Google Sheets pour comprendre les données, apprendre SQL pour les interroger, utiliser Power Query pour fiabiliser les transformations, puis passer à Power BI pour restituer les résultats. Python intervient ensuite lorsque l’automatisation, les calculs spécifiques ou la répétabilité deviennent nécessaires.
Dans une PME, une combinaison SQL, Power Query et Power BI peut répondre à de nombreux besoins de reporting si les sources sont bien identifiées. Une équipe produit ou recherche qui analyse des entretiens clients ajoutera un outil de codage qualitatif tel que NVivo, Dovetail ou Thematic. Un analyste confirmé travaillant sur des sources nombreuses privilégiera SQL et Python, puis alimentera un tableau de bord pour partager les résultats.
Les critères qui sécurisent le choix d’un outil
Avant de comparer les fonctionnalités, partez d’un cas d’usage précis : répondre à une question client, automatiser un rapport, analyser des retours d’enquête ou relier plusieurs sources métier. Vérifiez ensuite le volume, la variété et la vitesse d’arrivée des données. Un fichier mensuel ne demande pas la même organisation qu’un flux issu d’API, de services cloud et de bases de données.
- Facilité d’adoption : l’outil doit être utilisable par les personnes qui produiront et liront l’analyse.
- Interopérabilité : contrôlez les connecteurs, les imports CSV et JSON, ainsi que la capacité à dialoguer avec vos bases et services.
- Évolutivité : anticipez l’augmentation des volumes, des utilisateurs et des besoins d’automatisation.
- Traçabilité : conservez les requêtes, scripts ou étapes de transformation pour rendre les résultats reproductibles.
- Sécurité et droits d’accès : protégez les données sensibles et limitez les accès selon les rôles.
Enfin, évitez de dépendre d’un seul environnement. SQL, Python, les solutions open source et les plateformes propriétaires peuvent coexister. Une organisation gagne surtout à disposer d’un processus documenté : données collectées, règles de nettoyage, calculs validés et restitution compréhensible. Cette chaîne cohérente transforme les données en décisions exploitables.